Benchmark LLM local & GPU – Forfait 1 jour Images
Benchmark LLM local & GPU – Forfait 1 jour
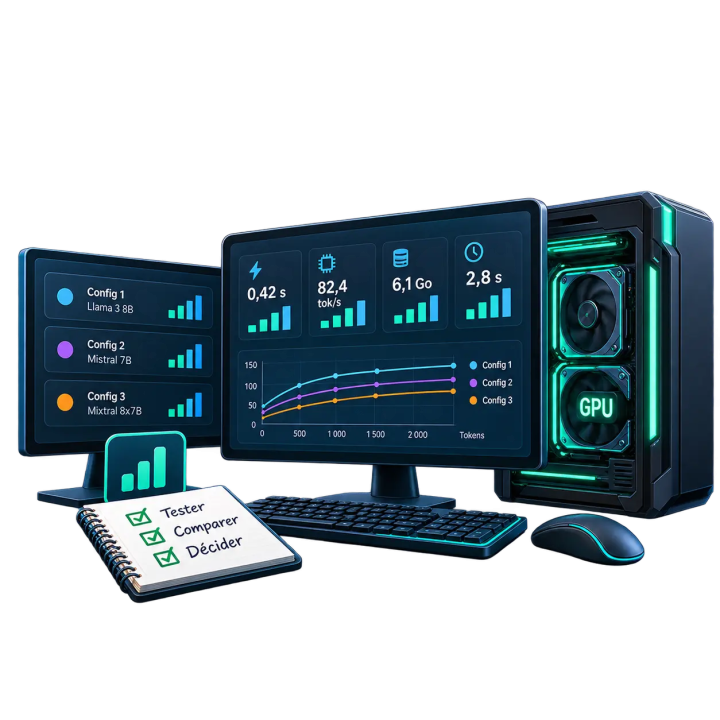
Benchmark LLM local & GPU pour comparer jusqu’à 3 configurations modèle / quantification / paramétrage sur une machine déjà opérationnelle, avec 2 GPU maximum.
Inclus : forfait 1 jour / 7h à distance, protocole documenté, jusqu’à 18 lots de mesure, résultats CSV/JSON, note d’interprétation et restitution de 45 min.
Tarif : 1 100 € HT / 1 320 € TTC indicatif. Aucun achat matériel ni gain de performance garanti.
Le forfait Benchmark LLM local & GPU vous aide à choisir vos réglages d’inférence à partir de mesures concrètes, et pas seulement à partir de fiches techniques.
- Format : benchmark ponctuel à distance
- Durée : forfait 1 jour, soit jusqu’à 7h de travail expert
- Périmètre : 1 machine existante, jusqu’à 2 GPU installés et fonctionnels
- Comparaison : jusqu’à 3 configurations modèle / quantification / paramétrage déjà disponibles
- Livrables : résultats CSV/JSON, protocole documenté, note d’interprétation et recommandations
- Restitution : 45 min en visioconférence, jusqu’à 5 participants
Objectif
Disposer d’un comparatif contextualisé pour arbitrer entre réactivité, capacité, contraintes mémoire et stabilité d’exécution sur votre matériel existant.
L’objectif est de mesurer, dans un cadre borné, plusieurs configurations LLM locales afin de mieux choisir un modèle, une quantification, un paramétrage ou un compromis d’exploitation avant une mise en production, une montée en charge ou une décision d’équipement.
Cette prestation ne garantit pas un gain de performance. Elle produit des mesures, une méthode reproductible et une interprétation utile à la décision.
Pour qui ?
- Équipes techniques qui exploitent déjà un moteur d’inférence local.
- TPE, PME, éditeurs ou structures qui veulent comparer plusieurs modèles ou réglages avant déploiement.
- Organisations qui hésitent entre plusieurs quantifications, tailles de modèles ou paramètres d’inférence.
- Équipes qui veulent objectiver la latence, le débit, la mémoire et les erreurs observées sur leur matériel réel.
- Clients qui disposent déjà d’une machine GPU opérationnelle et souhaitent éviter les décisions uniquement fondées sur des benchmarks génériques.
Périmètre standard
- 1 machine existante.
- Jusqu’à 2 GPU installés, reconnus et fonctionnels.
- 1 système d’exploitation.
- 1 moteur d’inférence déjà installé et opérationnel.
- Jusqu’à 3 configurations déjà disponibles : modèle, quantification ou paramétrage, sur le même moteur.
- 2 profils de charge définis au cadrage.
- Jusqu’à 3 répétitions par configuration et par profil.
- Maximum 18 lots de mesure : 3 configurations × 2 profils × 3 répétitions.
- Fenêtre de charge plafonnée à 4h dans l’enveloppe totale de 7h.
- Un petit jeu de tâches synthétiques ou fourni par le client peut compléter la mesure technique lorsque disponible.
Méthodologie & niveau de profondeur
- Relevé du matériel, des versions logicielles, du moteur d’inférence et des modèles disponibles.
- Définition d’un protocole simple, explicite et reproductible dans le cadre de la mission.
- Mesures réalisées uniquement sur les configurations disponibles et fonctionnelles au moment de l’intervention.
- Séparation des mesures à froid et après échauffement lorsque cela est pertinent.
- Exécution de lots bornés, dans une fenêtre de charge autorisée.
- Analyse des résultats avec leurs limites : cache, tokenizer, paramètres, qualité des réponses, charge concurrente, erreurs ou mesures manquantes.
- Aucune extrapolation non mesurée n’est présentée comme un fait.
Configurations comparées
- Jusqu’à 3 configurations déjà prêtes au moment de l’intervention.
- Une configuration peut correspondre à un modèle, une quantification, un paramétrage de génération ou une combinaison de ces éléments.
- Les configurations doivent utiliser le même moteur d’inférence dans le périmètre standard.
- Les modèles doivent être déjà installés, accessibles et utilisables légalement par le client.
- Les droits d’usage des modèles, licences, poids, quantifications et dépendances relèvent du client.
Mesures réalisées
- Délai avant le premier token lorsque la métrique est disponible.
- Latence de bout en bout.
- Débit en tokens par seconde lorsque mesurable.
- Débit en requêtes ou traitements selon le profil de charge retenu.
- Utilisation mémoire lorsque la métrique est accessible.
- Erreurs, dépassements de délai, essais interrompus et comportements non comparables.
- Médiane et percentile 95 lorsque le nombre d’observations le permet, avec l’effectif mesuré.
Profils de charge
- 2 profils de charge définis au cadrage.
- Exemples : requête courte interactive, requête longue, contexte documentaire, génération contrôlée, usage avec concurrence limitée.
- La taille des lots, les paramètres de génération, la concurrence, les limites et les critères d’arrêt sont fixés avant les mesures.
- Les profils doivent rester compatibles avec une fenêtre de charge plafonnée à 4h.
- Le benchmark ne vise pas à saturer ou dégrader volontairement l’environnement.
Charge maîtrisée & critères d’arrêt
- Les tests sont réalisés uniquement dans une fenêtre explicitement autorisée.
- Aucun test destructif, déni de service ou saturation non maîtrisée n’est réalisé.
- Les critères d’arrêt sont définis au cadrage : surcharge, erreurs répétées, température, instabilité, indisponibilité ou risque opérationnel.
- Un lot interrompu ou non comparable reste documenté comme tel dans les résultats.
- Les dépassements de délai et essais interrompus sont inclus dans le bilan, sans être maquillés en succès.
Consommation facultative
- La puissance ou l’énergie consommée peut être relevée uniquement si une instrumentation fiable et accessible existe déjà.
- Le périmètre mesuré est précisé : machine complète, GPU, moteur, processus ou autre métrique disponible.
- Aucune valeur énergétique n’est inventée ou extrapolée sans mesure exploitable.
- Si l’instrumentation est absente ou insuffisante, la consommation est indiquée comme non mesurée.
Livrables
- Tableau comparatif des configurations testées.
- Résultats bruts expurgés en CSV/JSON.
- Protocole de mesure documenté : versions, paramètres, profils de charge, conditions, limites et critères d’arrêt.
- Scripts ou commandes de mesure créés pour la mission, lorsque cela est applicable et livrable sans secret.
- Note d’interprétation : capacité observée, limites, erreurs, points non comparables et recommandations de réglage.
- Restitution de 45 min en visioconférence, jusqu’à 5 participants.
Déroulé / Comment ça se passe
- Vous commandez le forfait ou demandez un cadrage préalable si le périmètre doit être validé avant achat.
- Le périmètre est confirmé : machine, GPU, système, moteur d’inférence, modèles, configurations et objectifs de mesure.
- Les prérequis sont vérifiés : accès, modèles disponibles, métriques, fenêtre de charge et droits d’usage.
- Le protocole de benchmark est défini : configurations, profils de charge, répétitions, paramètres et critères d’arrêt.
- Les mesures sont exécutées dans la fenêtre autorisée.
- Les résultats sont consolidés, expurgés et structurés en CSV/JSON.
- Une note d’interprétation présente les compromis observés et recommandations de réglage.
- Une restitution de 45 min permet de présenter les résultats, limites et suites possibles.
Délais & disponibilité
- Prestation à distance, en français, destinée principalement aux professionnels.
- Une journée représente 7h de travail expert, répartissables sur plusieurs dates.
- Le temps annoncé comprend cadrage, vérification de l’existant, mesures, analyse, documentation et restitution.
- Livraison cible sous 10 jours ouvrés après réception des accès et préparation des modèles.
- La commande porte sur une quantité de prestation, pas sur une date réservée.
- Le périmètre, les prérequis et le planning sont confirmés avant intervention.
- Si le besoin dépasse le forfait, aucun supplément n’est engagé sans accord écrit.
- Une commande non éligible n’est pas exécutée : une adaptation est proposée ou la partie non réalisée est remboursée selon les conditions applicables.
Facturation, engagement & évolution du périmètre
- Prix standard : 1 100 € HT / 1 320 € TTC indicatif.
- Le forfait couvre jusqu’à 7h de travail expert.
- La quantité 1 correspond à 1 forfait de benchmark d’une journée.
- Le prix suppose que la machine, les pilotes, le moteur d’inférence et les modèles sont déjà installés et fonctionnels.
- Les coûts tiers ne sont pas inclus : matériel, GPU, cloud, API, licences, modèles commerciaux, stockage ou abonnements fournisseurs.
- Les besoins hors forfait : installation de pilotes, installation de modèles lourds, benchmark distribué, multi-machines, multi-moteurs ou tests longue durée, sont traités sur devis.
Pré-requis
- Machine déjà opérationnelle.
- Jusqu’à 2 GPU installés, reconnus et fonctionnels.
- Pilotes, runtime, moteur d’inférence et dépendances déjà installés.
- Modèles et configurations déjà disponibles avant intervention.
- Droits d’usage validés sur les modèles, poids, quantifications, outils et jeux de tâches fournis.
- Accès temporaire adapté aux mesures.
- Accès aux métriques utiles lorsque disponibles : latence, débit, mémoire, erreurs, logs ou observabilité existante.
- Fenêtre de charge autorisée par le client.
- Objectifs connus : latence cible, concurrence attendue, contrainte mémoire, confidentialité, usage métier ou arbitrage matériel.
- Jeu de tâches métier fourni par le client si une appréciation d’usage spécifique est attendue.
- Aucun mot de passe, jeton, clé privée ni donnée sensible ne doit être joint à une commande ou envoyé par e-mail.
Recette & critères de validation
- Les livrables indiquent exactement les configurations et lots effectivement mesurés.
- Un lot non réalisé est indiqué comme non réalisé, avec justification.
- Un résultat non comparable est signalé explicitement.
- Un échantillon insuffisant n’est pas transformé en conclusion définitive.
- Les métriques indisponibles sont indiquées comme non mesurées.
- Aucune extrapolation n’est présentée comme un fait mesuré.
- La recette porte sur la remise des livrables, la traçabilité du protocole et l’explicitation des limites.
Confidentialité & conservation
- Les accès sont temporaires et limités au strict nécessaire.
- Un canal adapté est convenu au cadrage pour les éléments sensibles.
- Aucun mot de passe, jeton, clé privée ni dépôt confidentiel ne doit être transmis en clair ou joint à une commande.
- Les résultats bruts sont expurgés lorsque nécessaire avant livraison.
- Aucun recours à un modèle externe sur les données client n’est réalisé sans autorisation écrite spécifique.
- Les copies de travail de la mission sont supprimées au plus tard 30 jours après la restitution finale, sauf obligation légale ou autre durée convenue par écrit.
Limites / Hors périmètre
- L’installation de pilotes ou de modèles lourds n’est pas incluse.
- La réparation de matériel n’est pas incluse.
- L’achat, le prêt ou la recommandation engageante de GPU n’est pas inclus.
- Le benchmark de cluster distribué n’est pas inclus.
- L’entraînement, le fine-tuning ou l’optimisation profonde de modèle ne sont pas inclus.
- L’audit de sécurité de l’environnement IA n’est pas inclus.
- La certification de performance n’est pas incluse.
- Aucun gain de performance, retour sur investissement ou comportement futur stable n’est garanti.
- La qualité fonctionnelle des réponses des modèles n’est pas évaluée de manière générale dans ce forfait.
- Les différences liées au tokenizer, au cache, au contexte, aux paramètres ou à la qualité des modèles sont signalées mais ne sont pas toujours isolables complètement.
Ce qui dépend de tiers
- Les performances dépendent du matériel, des pilotes, du moteur d’inférence, des modèles, des quantifications et des versions réellement installées.
- Les droits d’usage, licences, restrictions et conditions des modèles relèvent du client ou du fournisseur concerné.
- Les métriques disponibles dépendent des outils, logs, API, moteurs d’inférence et systèmes d’observabilité présents.
- Les coûts, quotas, licences, limitations et indisponibilités de services tiers ne sont pas inclus dans la prestation.
- Les mesures peuvent varier selon la charge concurrente, l’état des caches, la température, la mémoire disponible, les autres processus et les conditions d’exécution.
Définitions de périmètre
- Une configuration correspond à une combinaison modèle / quantification / paramètres testée dans le protocole.
- Un profil de charge correspond à un cas de mesure défini : type de prompt, longueur, concurrence, objectif et paramètres associés.
- Un lot de mesure correspond à l’exécution d’une configuration sur un profil de charge donné.
- Les répétitions servent à réduire les effets ponctuels, mais ne transforment pas un benchmark court en étude statistique exhaustive.
- Le périmètre mesuré correspond aux versions, paramètres, accès, modèles et conditions observés pendant la mission.
Besoin de sécuriser l’environnement IA local ?
Ce forfait mesure les performances. Il ne constitue pas un audit de sécurité de l’environnement IA local, des serveurs MCP, des permissions, du routage, des fallbacks ou des agents de code.
Besoin d’un parcours audit + durcissement ?
Si votre objectif est de sécuriser puis durcir une infrastructure IA locale, avec cartographie MCP, tests de fuite simulée, corrections prioritaires et recette avant/après, le pack IA locale maîtrisée est plus adapté.
Besoin d’un projet IA plus large ?
Si le besoin porte sur la mise en place d’une solution IA complète, un chatbot, un RAG métier, Open WebUI, une API fournisseur, un serveur IA ou une intégration métier, une prestation IA sur mesure est plus adaptée.
Aller plus loin
- Audit de sécurité IA locale & MCP – Forfait 3 jours
- Pack IA locale maîtrisée – Audit & durcissement
- IA & automatisation – cadrage, intégration et déploiement sur mesure
FAQ
Garantissez-vous une amélioration de performance ?
Non. Le service produit des mesures et recommandations. Le meilleur réglage dépend du matériel, du modèle, de la charge, des paramètres et du niveau de qualité requis.
Fournissez-vous les GPU ?
Non. Le forfait porte sur le matériel déjà disponible chez vous ou chez votre hébergeur autorisé. Aucun achat, prêt ou location de GPU n’est inclus.
Les modèles doivent-ils déjà être installés ?
Oui. Le forfait suppose que la machine, les pilotes, le moteur d’inférence et les modèles à comparer sont déjà installés et opérationnels.
Combien de configurations peut-on comparer ?
Le périmètre standard couvre jusqu’à 3 configurations modèle / quantification / paramétrage sur le même moteur d’inférence.
Combien de mesures sont réalisées ?
Le forfait couvre jusqu’à 2 profils de charge, 3 configurations et 3 répétitions, soit 18 lots de mesure maximum.
Est-ce identique à la mesure incluse dans l’audit IA locale & MCP ?
Non. L’audit comprend un point indicatif sur 1 configuration. Ce forfait ajoute un protocole comparatif plus approfondi, jusqu’à 3 configurations, avec résultats CSV/JSON et note d’interprétation dédiée.
Évaluez-vous la qualité des réponses des modèles ?
Pas de manière générale. Un petit jeu de tâches synthétiques ou fourni par le client peut compléter les mesures techniques, mais cela ne constitue pas une évaluation complète des capacités ou de la qualité des modèles.
Mesurez-vous la consommation électrique ?
Seulement si une instrumentation fiable existe déjà. Si la mesure de puissance ou d’énergie n’est pas disponible, elle est indiquée comme non mesurée.
Peut-on benchmarker plusieurs machines ou un cluster ?
Non, pas dans le périmètre standard. Plusieurs machines, clusters distribués, multi-moteurs ou environnements complexes nécessitent un cadrage spécifique.
Est-ce un audit de sécurité ?
Non. Ce forfait mesure et compare les performances d’inférence. Pour vérifier les risques liés aux agents IA, serveurs MCP, permissions, exfiltration simulée, routage ou fallbacks, il faut choisir l’audit de sécurité IA locale & MCP.
Comment commander ?
Vérifiez les plafonds du forfait : 1 machine, jusqu’à 2 GPU, 1 moteur d’inférence, jusqu’à 3 configurations déjà disponibles et 2 profils de charge. Pour un besoin plus large ou un doute sur l’éligibilité, demandez un cadrage avant achat.
-
Marque